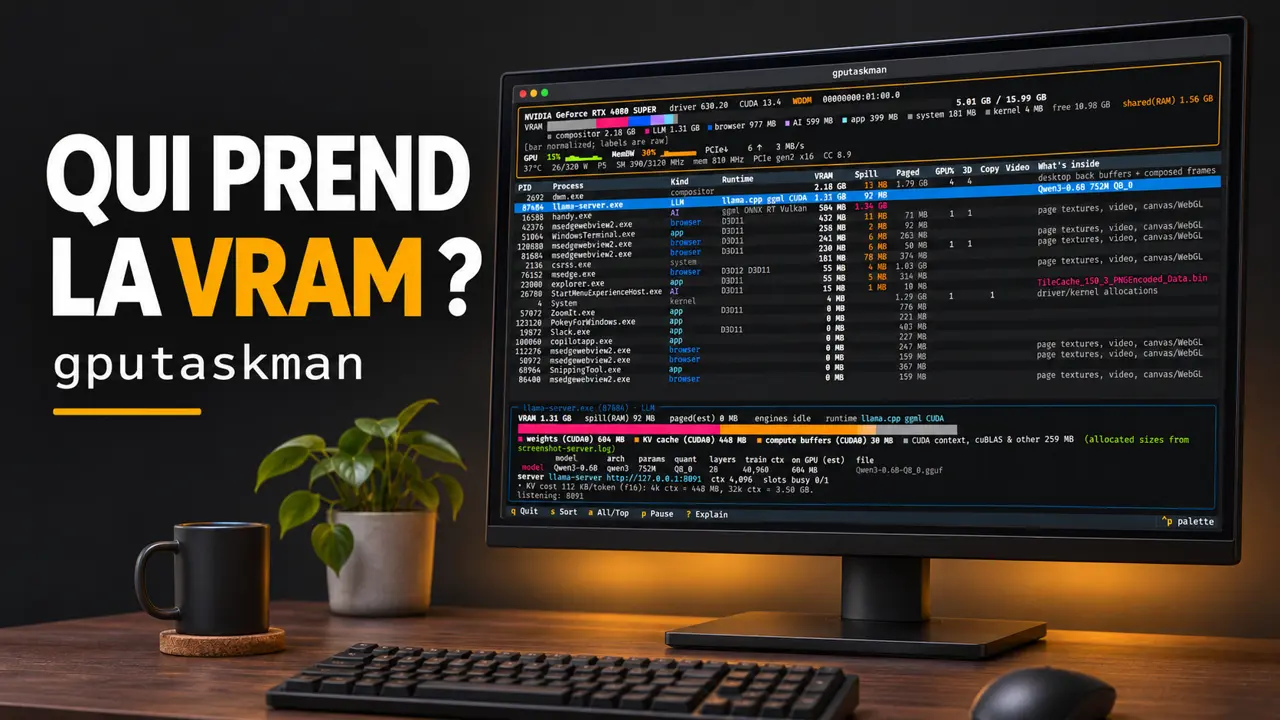
Imagine que ta carte graphique affiche 11 Go utilisés sur 12. Très bien, mais quelle application les occupe ? Et si c’est ton modèle d’IA local, est-ce le modèle lui-même ou le contexte de la conversation qui a fait grimper le compteur ? gputaskman rapproche ces informations dans une interface de terminal : la mémoire par processus, l’activité des moteurs du GPU et, lorsque les données sont disponibles, des détails sur les modèles chargés. Le projet libre de Scott Hanselman, publié sous licence MIT, est passé en version 0.4.0 le 11 novembre. Il est indépendant de Microsoft.
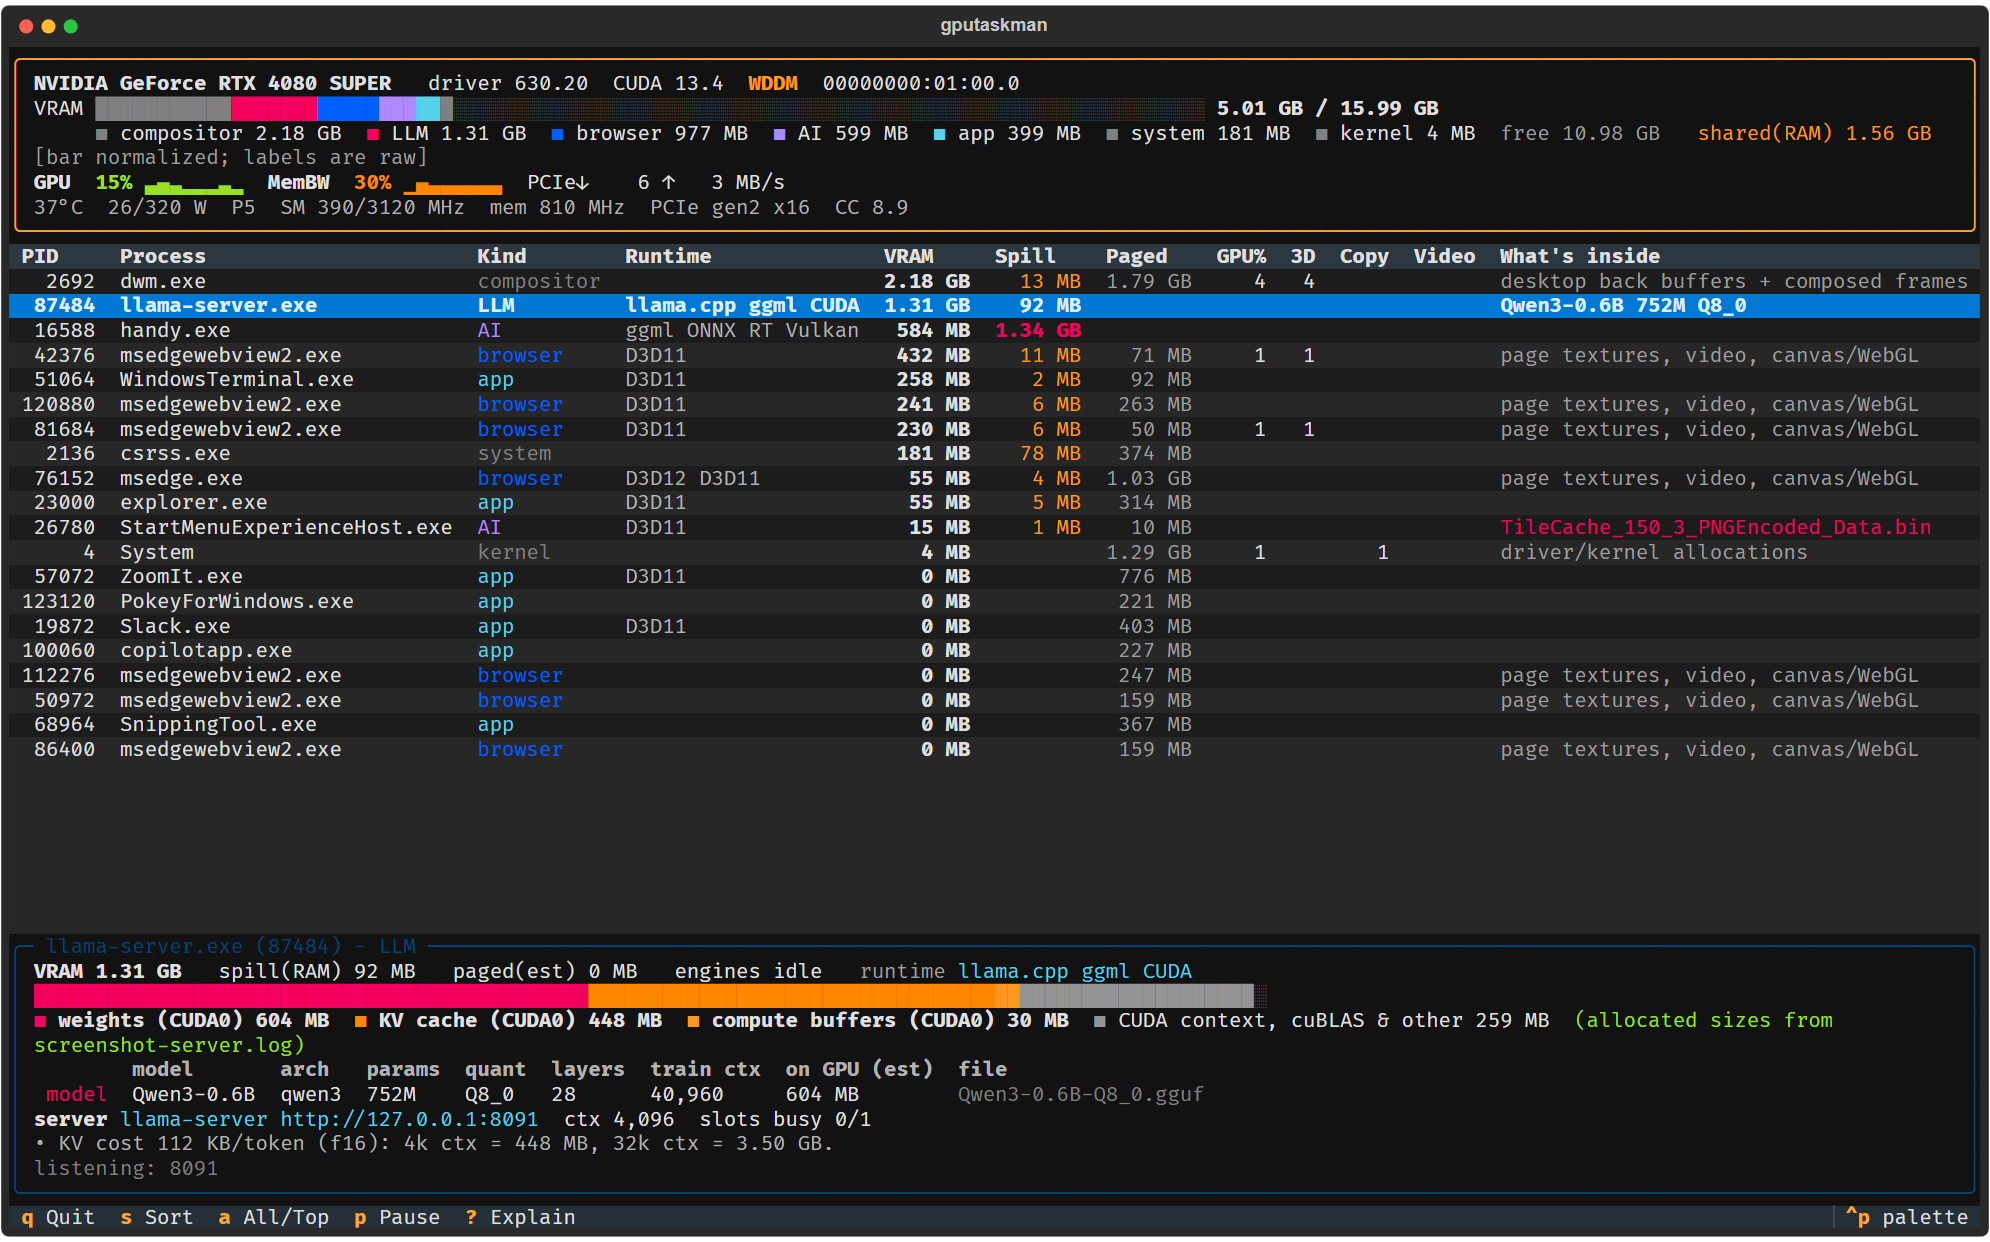
Lire la mémoire et l’activité côte à côte
Un processus peut réserver plusieurs gigaoctets sans calculer en permanence. À l’inverse, un encodeur vidéo peut solliciter une partie du GPU tout en restant relativement discret côté mémoire. gputaskman aide à distinguer ces situations : selon le matériel et le pilote, il donne accès à la mémoire utilisée par processus, à l’activité des moteurs 3D, calcul ou vidéo, ainsi qu’à des mesures comme la température et la puissance de la carte.
La présentation reprend l’esprit d’htop : une vue de l’appareil en haut et des lignes pour les processus en dessous. Elle peut signaler des bibliothèques et moteurs connus, comme CUDA, Vulkan ou ggml. Une bibliothèque détectée est un indice sur l’usage du processus. La mémoire partagée entre plusieurs programmes peut aussi compliquer les totaux : additionner toutes les lignes ne suffit pas toujours à retrouver exactement le chiffre global.
Pourquoi c’est utile quand on lance une IA en local
Au démarrage, un modèle charge ses poids. Pendant la génération, le cache KV conserve des informations calculées sur les jetons précédents afin d’éviter de tout recalculer à chaque réponse. Un contexte plus long ou plusieurs demandes simultanées peuvent augmenter les besoins en mémoire, même si le fichier du modèle n’a pas changé. D’autres tampons servent encore au calcul. C’est ce mélange qui rend un simple chiffre d’occupation difficile à interpréter.
gputaskman peut reconnaître des modèles à partir de fichiers et de magasins utilisés par Ollama, LM Studio ou Hugging Face, puis exploiter les journaux ou les données de certains serveurs locaux. Toutes les valeurs de cette décomposition ne sont pas des mesures directes : le programme peut en estimer certaines à partir des métadonnées GGUF et des paramètres détectés. Je l’utiliserais pour comparer deux exécutions sur la même machine — même modèle, mais contexte plus court — plutôt que pour tirer une conclusion au mégaoctet près.
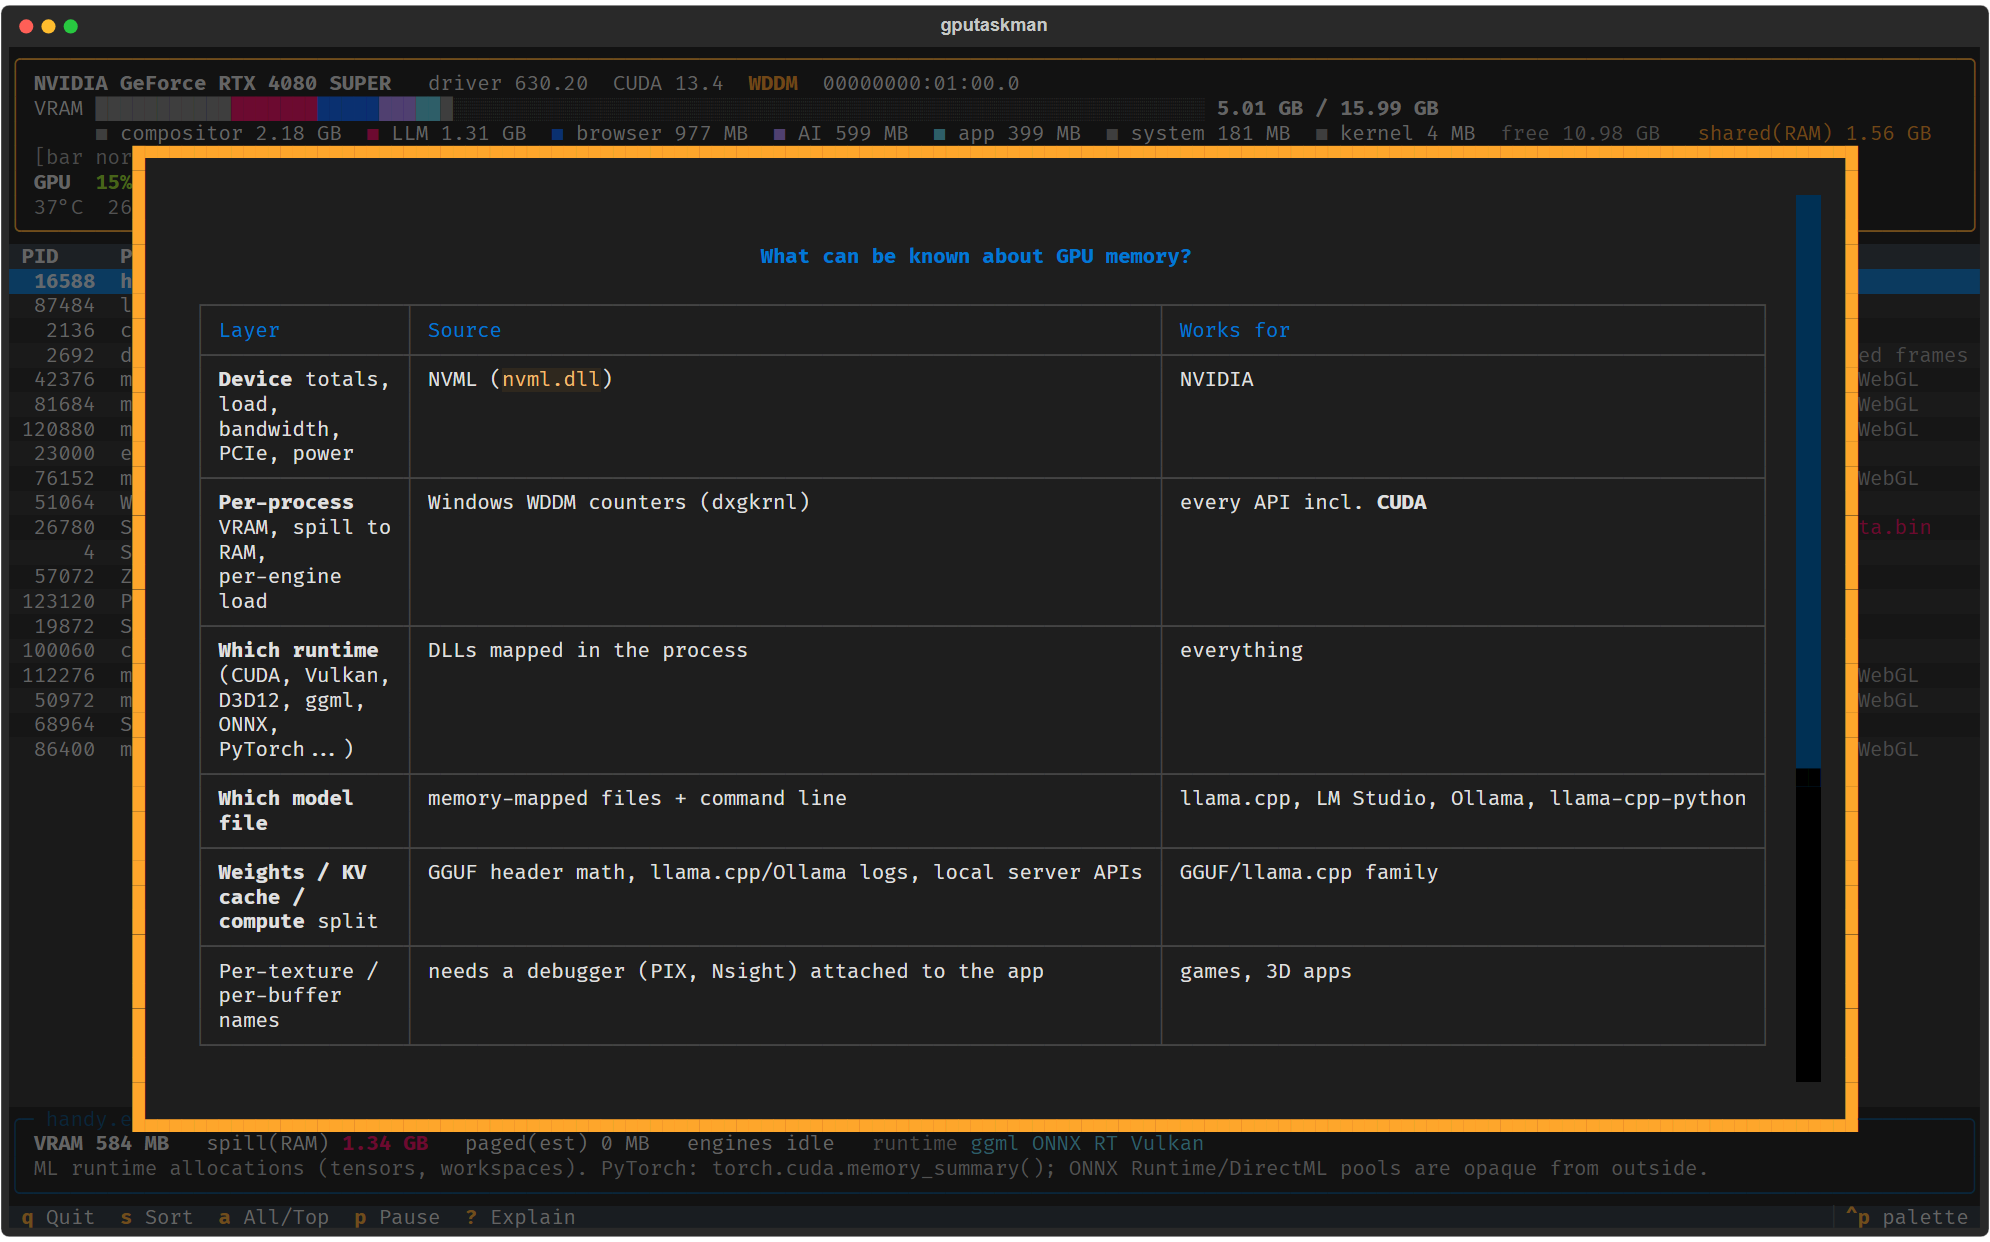
Compatibilité et nouveautés de la version 0.4.0
| Système | Ce qu’il faut savoir |
|---|---|
| Windows | Télémétrie AMD et NVIDIA, activité Intel via WDDM. Le niveau de détail varie selon le pilote. |
| Linux et WSL | NVIDIA pris en charge ; AMD et Intel sont aussi documentés pour Linux natif. La parité avec Windows ou WSL n’est pas systématique. |
| macOS | Prise en charge des Mac Apple Silicon. La mémoire est unifiée : il ne s’agit pas d’une quantité de VRAM dédiée comme sur une carte graphique séparée. |
La 0.4.0 ajoute sous Linux des mesures de charge globale, d’activité vidéo et de puissance pour Intel, avec les droits nécessaires pour certaines mesures. Elle ajoute aussi un premier support de l’accélérateur Huawei Ascend 310P sous Linux et corrige un cas de découverte de serveurs vLLM. Une valeur indisponible dépend parfois de ce qu’expose le pilote, et ne veut pas dire que le GPU est au repos.
Comment le lancer
Avec Python 3.11 ou plus et pipx, la commande documentée est pipx install gputaskman, puis gputaskman dans le terminal. Sous Windows, la page de la version 0.4.0 propose aussi des archives portables distinctes pour x64 et Arm64. Décompresse l’archive entière : l’exécutable a besoin du dossier qui l’accompagne. Pour une première lecture, compare un relevé au repos avec un relevé pendant ton usage habituel. C’est souvent suffisant pour repérer le programme qui change vraiment la donne.
 SUR LA CHAÎNE · NOUVELLE VIDÉO Zelda Ocarina of Time sur Switch 2 : la première heure de jeu en 4K 60 Voir la vidéo →
À lire aussi
 ARTICLE · 1 NOV. GeForce RTX : cet outil sur clé USB débloque certains calculs IA sous Windows
 ARTICLE · 26 OCT. GPU Unlock : des GeForce gagnent en calcul IA, mais les chiffres demandent à être décodés
 ARTICLE · 17 FÉVR. Comment installer composer sur son ordinateur ?
 ARTICLE · 8 OCT. Copilot et recherche Windows : ce que Microsoft change avec l’IA hybride
 ARTICLE · 13 OCT. A peine dispo, la GeForce RTX4090 Founders Edition en rupture de stock !
 ARTICLE · 4 NOV. GIMP 3.2.8 : un outil Texte plus fiable et des lenteurs corrigées
Commentaires
0