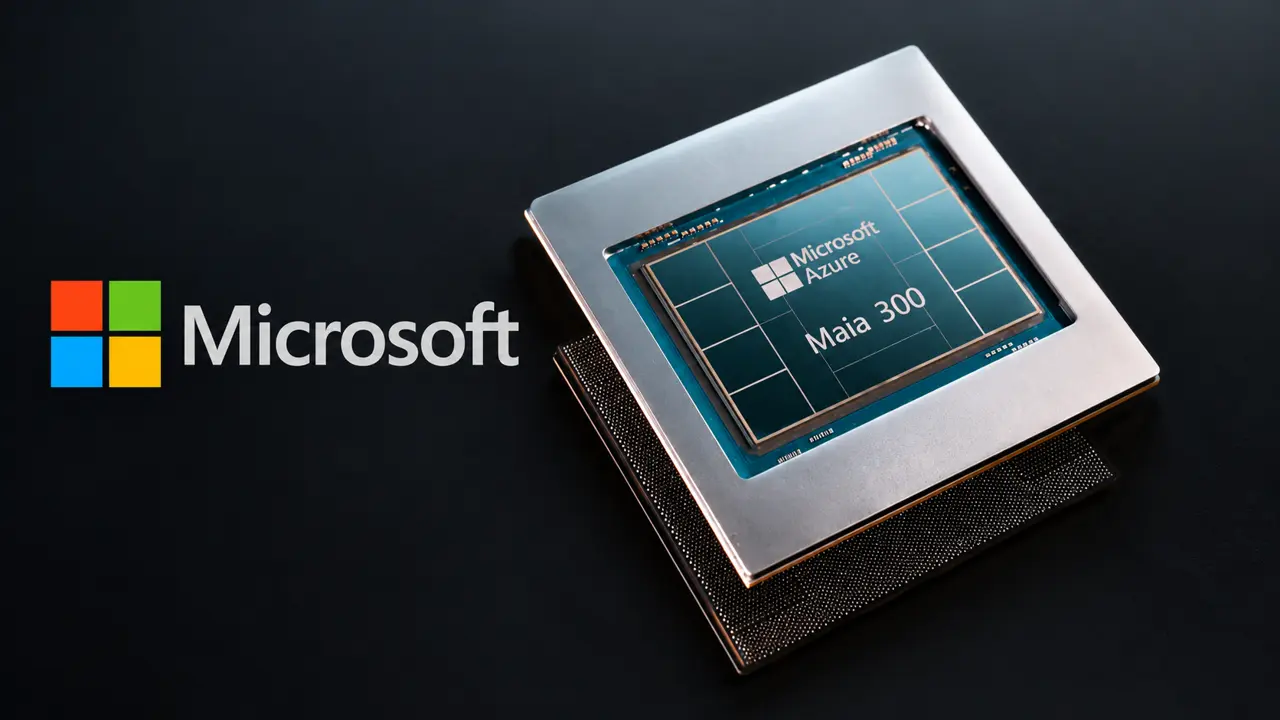
Microsoft veut faire tourner une plus grande partie de son IA sur ses propres puces. Ce 12 octobre 2026, l’entreprise présente Azure Maia 300, la troisième génération de ses accélérateurs maison, et annonce une montée en puissance de la famille Maia à partir de 2027. L’objectif est d’en faire le principal système d’inférence de ses produits et services.
Le chiffre mis en avant est ambitieux : Microsoft attend 40 % de tokens supplémentaires par mégawatt face aux systèmes GPU leaders du marché. Mais ce résultat annoncé mérite quelques explications. Il parle d’efficacité pour faire fonctionner des modèles d’IA, pas d’un assistant automatiquement 40 % plus intelligent, ni d’une réduction garantie de votre abonnement Copilot.
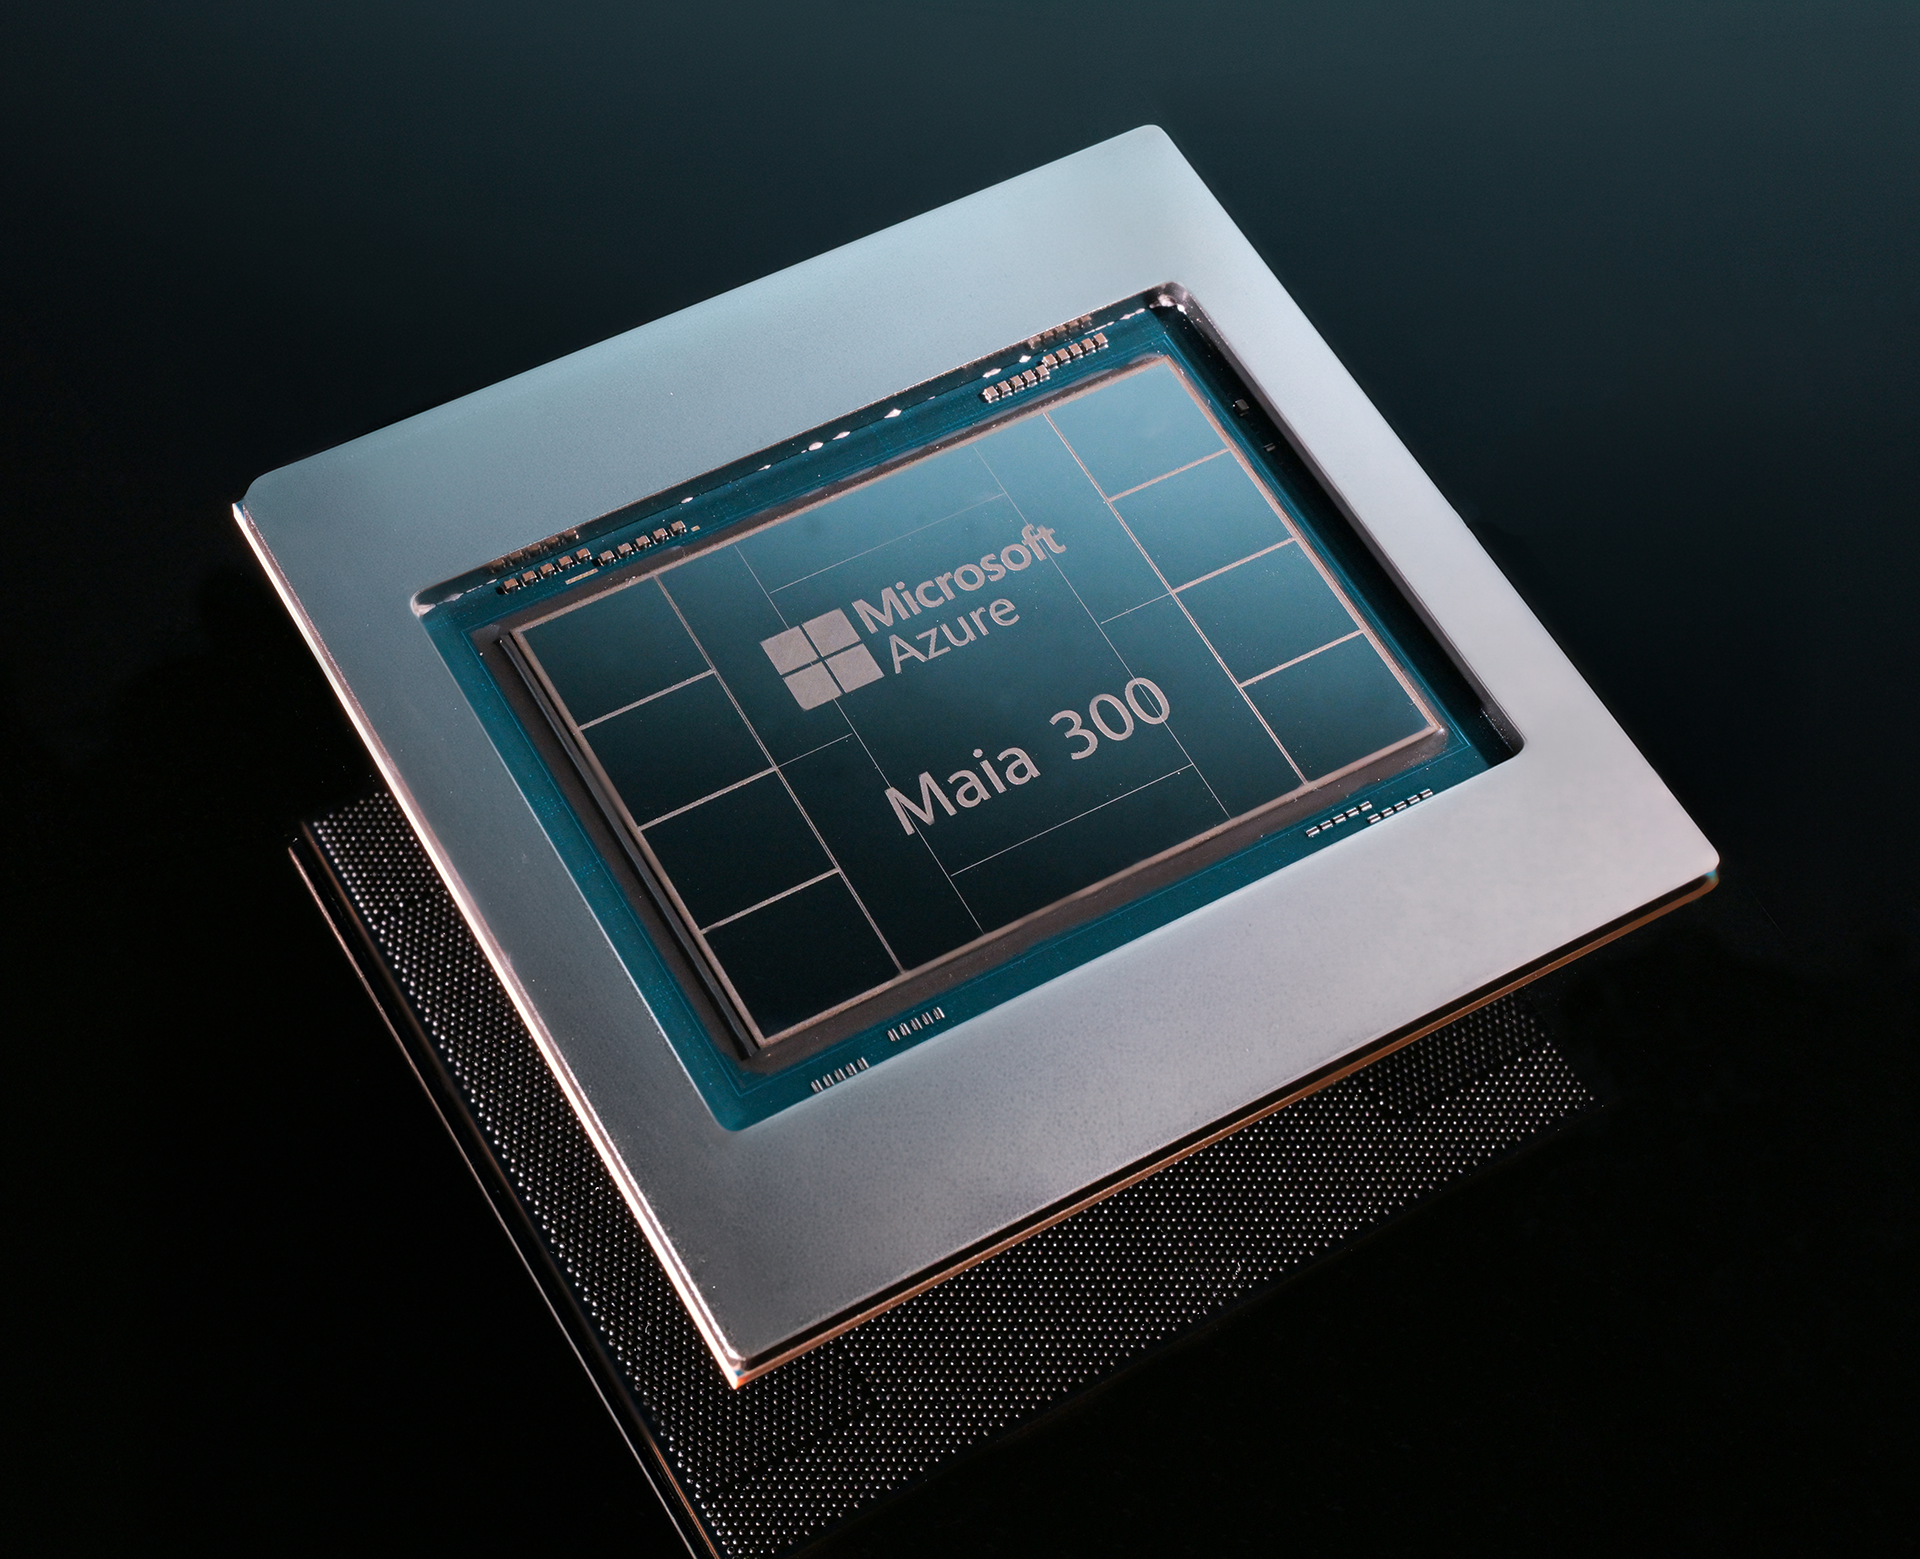
Maia 300 sert à exécuter l’IA, pas à remplacer le processeur de votre PC
Maia est une plateforme de datacenter. Vous ne retrouverez donc pas cette puce dans un ordinateur portable ou dans une carte graphique à installer chez vous. Son rôle est de traiter les demandes envoyées aux services de Microsoft, à une échelle où les performances, la consommation et le coût de fonctionnement deviennent indissociables.
Le mot important est inférence : il désigne l’utilisation d’un modèle déjà entraîné pour produire une réponse. Lorsque vous demandez à un assistant de résumer un document ou de proposer du code, le modèle doit exécuter des calculs pour répondre. Répétée pour de nombreux utilisateurs, cette opération représente un besoin continu d’infrastructure.
Les tokens sont les unités de données traitées par les modèles. Pour du texte, ils peuvent correspondre à un mot, à une partie de mot ou à d’autres éléments du contenu. Compter les tokens revient donc à mesurer une quantité de travail, avec des différences selon le modèle et la manière dont il découpe les données.
Cette distinction évite un raccourci courant : une nouvelle puce ne crée pas à elle seule un meilleur modèle. Elle peut rendre son utilisation plus efficace ou permettre de servir davantage de demandes. La qualité des réponses reste une autre question, liée notamment au modèle et à l’application qui l’utilise.
 SUR LA CHAÎNE · NOUVELLE VIDÉO JBL Charge 3 : NON à l’obsolescence programmée ! je change la batterie et port de charge Voir la vidéo →
Les 40 % annoncés ne signifient pas 40 % d’électricité économisée
Microsoft présente une amélioration du nombre de tokens traités pour une même puissance disponible. Le groupe ne précise pas, dans son annonce générale, quels systèmes GPU constituent exactement le point de comparaison. Le chiffre reste donc une projection du constructeur, à examiner avec sa méthode de mesure.
Un exemple purement illustratif aide à comprendre la différence. Imaginez une installation qui produit 100 unités de travail pour une puissance donnée. Une efficacité supérieure de 40 % lui permettrait d’en produire 140 avec cette même puissance. Elle peut donc fournir davantage de calcul sans augmenter proportionnellement son alimentation électrique.
Si l’objectif était au contraire de conserver exactement la même quantité de travail, le calcul théorique donnerait une puissance nécessaire divisée par 1,4, soit une baisse d’environ 29 %. Ce n’est pas une prévision de consommation réelle pour Maia 300 : cela montre simplement pourquoi « 40 % plus efficace » et « 40 % moins gourmand » ne sont pas interchangeables.
Il faut également distinguer débit global et temps de réponse individuel. Une infrastructure capable de traiter plus de demandes simultanées n’accélère pas forcément chaque conversation dans la même proportion. Pour juger un résultat d’inférence, je voudrais connaître le modèle utilisé, la longueur des échanges, le nombre d’utilisateurs servis et les exigences de latence.
La comparaison doit aussi conserver une qualité de sortie comparable. Un chiffre impressionnant obtenu dans un usage très particulier ne suffit pas à décrire tous les services. L’annonce est prometteuse ; elle ne dispense pas de regarder ce que les mesures couvrent réellement.
Une architecture qui cherche à limiter les déplacements de données
Maia 300 adopte une architecture à chiplets, avec des fonctions de calcul, de contrôle mémoire et d’entrées-sorties séparées. Les éléments de calcul utilisent le procédé TSMC N2P. Microsoft organise aussi la mémoire autour de la proximité avec les unités qui l’exploitent, plutôt que de considérer tous les accès comme équivalents.
L’idée peut se comprendre sans entrer dans tous les détails électroniques. Un calculateur très rapide reste mal utilisé s’il attend constamment les données nécessaires à son travail. Améliorer l’ensemble demande donc de regarder le calcul, mais aussi la mémoire et les échanges entre composants.
Microsoft développe cette approche avec son architecture de circulation des données pilotée par le logiciel. Le placement et les transferts sont coordonnés pour rapprocher les informations du calcul qui en a besoin. Les formats de faible précision, dont une évolution de MXFP4, participent également à la réduction du volume de données à manipuler.
Ce choix illustre un enjeu plus large de l’IA : ajouter de la puissance brute ne résout pas automatiquement tous les blocages. Si une application attend la mémoire ou la communication entre plusieurs accélérateurs, multiplier les opérations théoriques par seconde ne suffit pas.
Le bénéfice dépend donc de la capacité du logiciel à exploiter le matériel. C’est l’intérêt d’une plateforme conçue autour de ses usages, mais aussi une raison de rester prudent face aux comparaisons trop générales. Une excellente configuration pour une famille de charges de travail n’est pas nécessairement supérieure dans toutes les autres.
288 Go de HBM4 par accélérateur, 96 accélérateurs par rack
Voici les principales caractéristiques communiquées par Microsoft. Les chiffres d’une puce et ceux d’un rack complet décrivent deux niveaux différents du système.
| Élément | Caractéristique annoncée |
|---|---|
| Mémoire par accélérateur | 288 Go de HBM4, répartis sur huit piles. |
| Bande passante mémoire | 18 To/s de pointe par accélérateur. |
| Enveloppe thermique | 950 W par accélérateur. |
| Rack complet | 96 accélérateurs dans une enveloppe de 167 kW. |
| Mémoire du rack | 27,6 To de capacité HBM. |
| Débit mémoire agrégé du rack | Environ 1,7 Po/s. |
| Interconnexion à grande échelle | Jusqu’à 12 288 accélérateurs dans un superpod. |
La HBM est une mémoire à très grande bande passante placée près du calculateur. Les nombres annoncés montrent surtout que Maia 300 est conçu pour des systèmes lourds, où le modèle et les données de travail doivent être distribués efficacement.
Attention à ne pas assimiler les 950 W au coût électrique total d’une machine. Le rack comprend d’autres éléments, et le datacenter doit aussi gérer son refroidissement et ses équipements annexes. Une enveloppe thermique de composant et la consommation totale d’un site ne se lisent pas de la même façon.
De même, la bande passante agrégée est la somme de capacités à l’échelle du système. Ce n’est pas la vitesse à laquelle votre demande Copilot traverse Internet, ni la garantie qu’une application isolée profite de toute cette capacité.
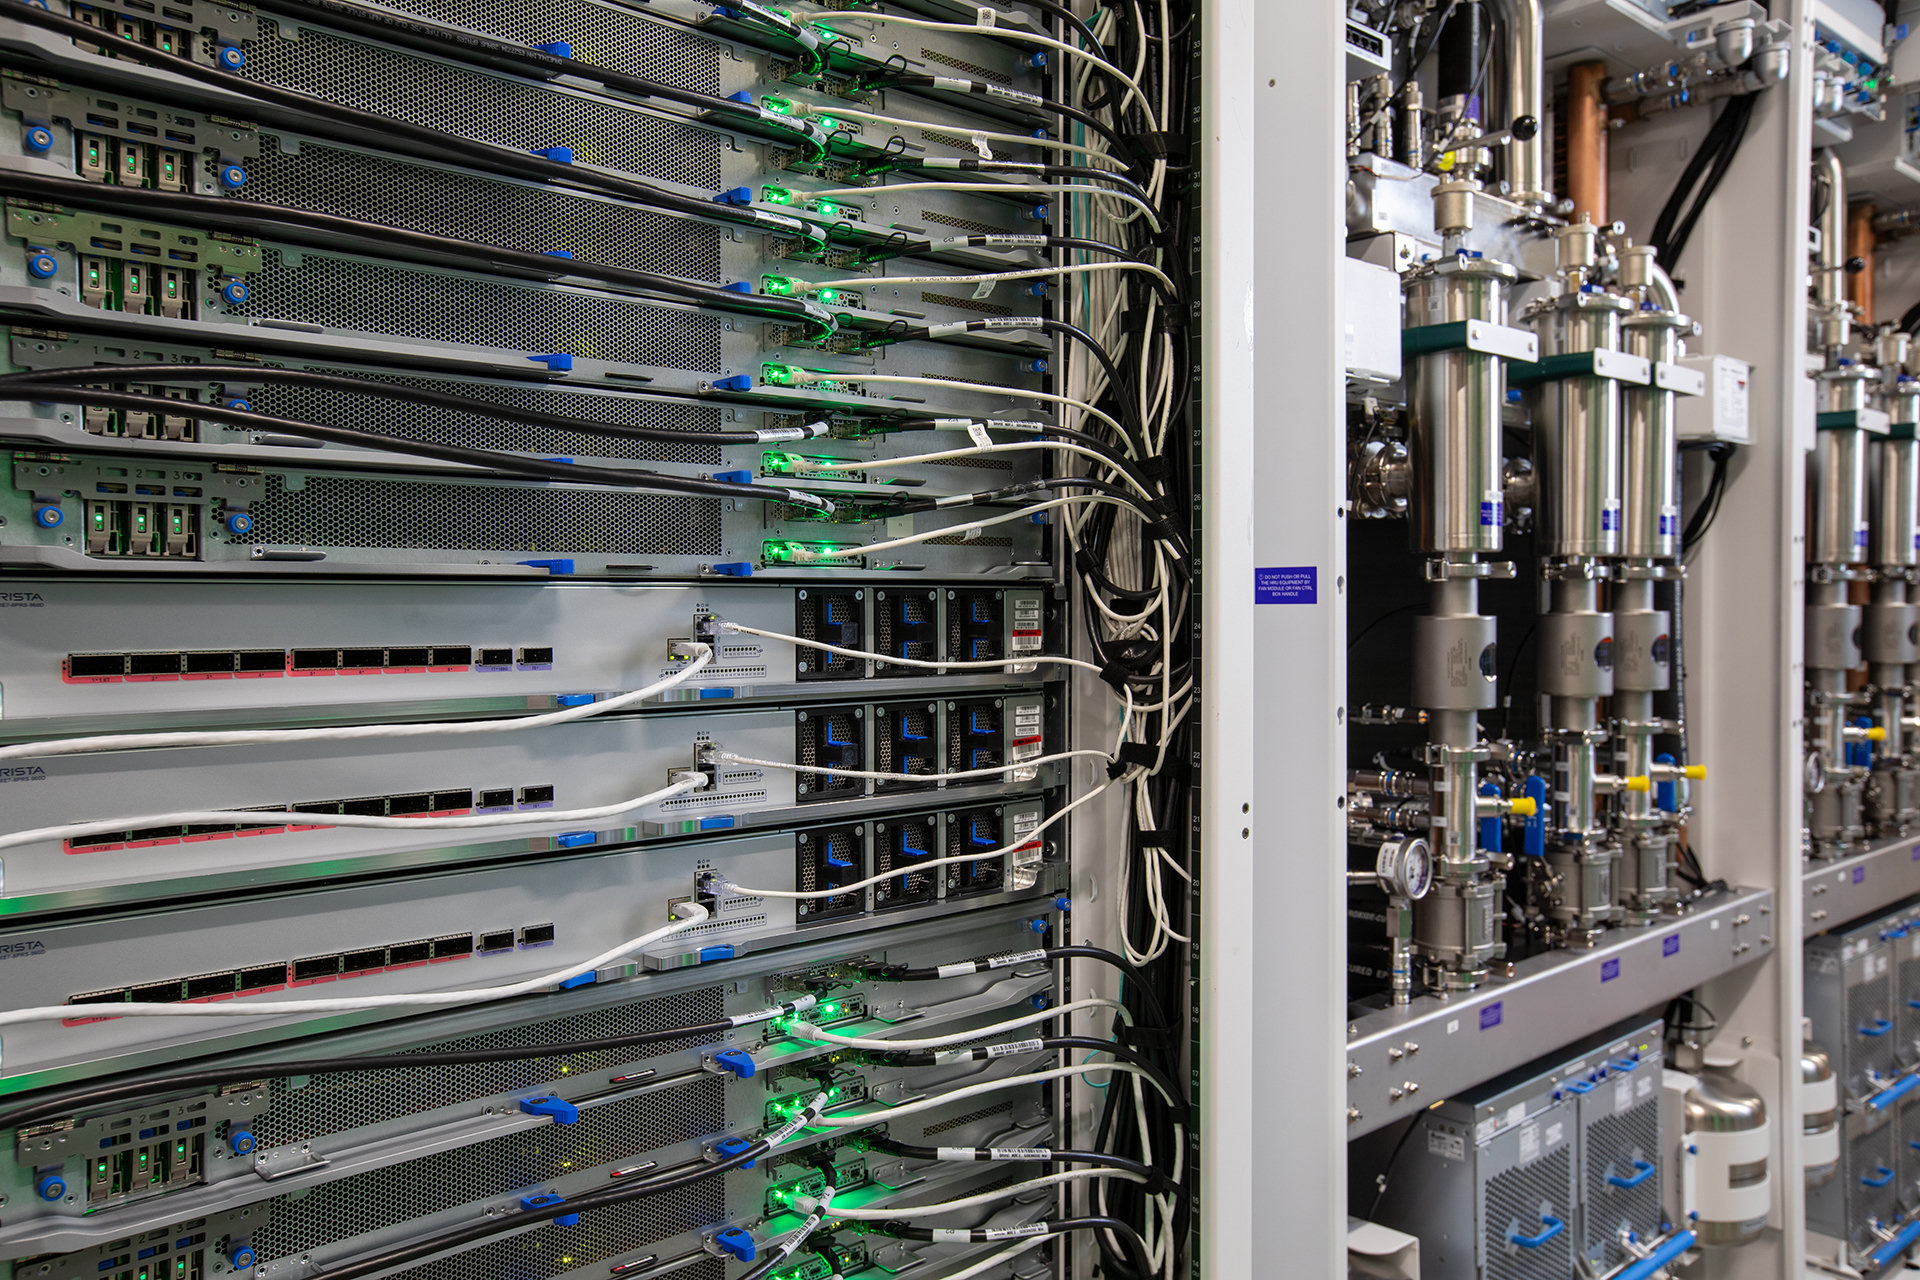
Le gain de sept fois concerne le rack, pas une seule puce
Microsoft annonce jusqu’à sept fois le débit de tokens par rack face à Maia 200, dans la configuration complète à 96 accélérateurs. C’est une comparaison entre systèmes : elle ne permet pas d’affirmer qu’une puce Maia 300 serait sept fois plus rapide qu’une Maia 200.
La densité du rack fait partie du résultat, tout comme les évolutions de mémoire, de réseau et de logiciel. Présenter uniquement le multiplicateur en oubliant la configuration rendrait l’annonce beaucoup plus spectaculaire, mais moins utile pour comprendre ce qui change.
Le même raisonnement s’applique à une comparaison avec Nvidia ou AMD. Il faut regarder des configurations capables de fournir le même service, avec les mêmes contraintes. Compter les accélérateurs ou comparer leur seule puissance électrique laisse de côté une grande partie du problème.
Maia 200 est déjà déployé, Maia 300 arrive en 2027
Le programme n’en est pas à sa première démonstration. Maia 200 est déjà déployé aux États-Unis, en Europe et en Australie. Microsoft annonce jusqu’à 1,7 fois plus de tokens par watt pour certaines expériences Teams, Copilot et Cowork, comparées à des infrastructures GPU de référence.
Pour Maia 300, les déploiements en production commenceront en 2027. La montée à plusieurs gigawatts concerne la famille Maia. Elle exprime l’ampleur de l’infrastructure visée ; elle ne signifie pas qu’une puce consomme plusieurs gigawatts.
Cette stratégie donne à Microsoft davantage de maîtrise sur le coût, l’approvisionnement et l’adaptation de son infrastructure. Mais elle ne signifie pas que le groupe abandonne tous les GPU externes : son annonce conserve une approche faisant place à plusieurs matériels et modèles.
Ce que cela pourrait changer pour les utilisateurs
Pour vous, la puce restera invisible derrière le service. Le bénéfice possible est une capacité accrue à répondre aux demandes, à soutenir des usages plus longs ou à contenir les coûts. Rien dans cette annonce ne garantit une baisse du prix de Copilot ou une accélération identique de chaque fonctionnalité.
Je retiens surtout le déplacement de l’enjeu : Microsoft cherche à optimiser le système entier, plutôt qu’à ajouter des accélérateurs sans regarder leur utilisation. C’est une direction intéressante lorsque la demande en calcul augmente, mais l’efficacité ne garantit pas à elle seule une baisse de la consommation totale si les usages progressent encore plus vite.
Le véritable test sera donc le déploiement à grande échelle : disponibilité, fiabilité, coût du travail effectivement réalisé et conditions des comparaisons. Maia 300 constitue une annonce importante pour l’infrastructure de Microsoft ; les résultats en production permettront de mesurer jusqu’où ses promesses se traduisent dans les services.
À lire aussi
 ARTICLE · 8 OCT. Copilot et recherche Windows : ce que Microsoft change avec l’IA hybride
 ARTICLE · 3 OCT. Windows 11 26H2 : les nouveautés utiles, et ce que Microsoft corrige enfin
 ARTICLE · 25 MARS Microsoft Edge : de nouveaux outils d'édition d'images alimentés par l'IA en phase de test
 ARTICLE · 2 JANV. Microsoft lance Copilot avec ChatGPT sur iOS
 ARTICLE · 6 DÉC. Windows 11 : Copilot fêtes ses 1 an et fait le plein de nouveautés et d'innovations
 ARTICLE · 26 SEPT. Windows 11 : Tout ce que vous devez savoir sur la mise à jour du 26 Septembre
Commentaires
0